不是更会聊天,而是把 AI 变成一个 if 判断:爆火的 Jev 到底是什么

不是更会聊天,而是把 AI 变成一个 if 判断:爆火的 Jev 到底是什么
沧浪同学这几天,一个叫 Jev 的新模型突然火了。
它的宣传数字很夸张:一次判断最快几十毫秒,输入价格只有每百万 token 0.042 美元。在 TypeSafe AI 自建的一组结构化工作流评测里,最高记录是 193.6 倍更快、444.6 倍更便宜。
但 Jev 真正有意思的地方,不是又造了一个更会聊天的大模型,而是它根本不想做聊天模型。
GPT、Claude 的核心工作是“生成”:写文章、解释问题、补代码。Jev 的核心工作只有两个字:判断。
给它一段当前状态,再提前规定可以回答什么,它不会写一篇分析,而是直接返回一个选项、分数或概率,让程序继续执行。
换句话说,Jev 想做的是软件里的智能 if 判断。
Jev 是谁做的,它为什么会在这时候出现
Jev 背后的公司是 TypeSafe AI,2024 年成立于旧金山。三位创始人分别是 CEO Diogo Almeida、COO Sasha Sheng 和 CTO Erik Gafni。
Almeida 曾在 Google Brain 和 OpenAI 工作,也是 2022 年 InstructGPT 论文的共同作者;Sheng 曾任 Meta/FAIR 研究工程师;Gafni 则有连续创业和生产级 AI 系统经验。
2026 年 9 月 15 日,TypeSafe 结束了约两年的隐身研发,正式发布 Jev,同时宣布获得约 4000 万美元种子轮融资,由 DCVC 领投。随后几天,Vercel AI Gateway、OpenRouter、Cloudflare 和 LangChain 相继提供接入方式。
它出现的时间点其实很好理解。过去两年,大家都在做 Agent(智能体),但一个 Agent 真正跑起来以后,最常做的往往不是写文章,而是一遍遍判断:
- 下一步调用哪个工具;
- 当前结果能不能交付;
- 应该继续、重试、追问用户,还是停止;
- 这次操作风险高不高;
- 这条内容该送进哪条流程。
通用大模型当然能做这些事,只是让一个昂贵的生成模型为每个小判断都写一段文字,再解析、校验和重试,多少有点杀鸡用牛刀。
Jev 瞄准的,正是这种数量很大、单次很小、又要求足够快的判断。
它不是缩小版 GPT,而是另一类模型
TypeSafe 把 Jev 称为第一款 System One Model(系统一模型)。这个名字来自丹尼尔·卡尼曼在《思考,快与慢》中对“系统一”和“系统二”的区分:前者负责快速、直觉式判断,后者负责缓慢、审慎推理。
如果把通用大模型看成一个会阅读、思考和表达的助手,Jev 更像嵌在软件内部的判断函数。

它接收一段 state(状态),可以是文字、JSON 对象、聊天记录或文本数组;然后回答程序预先定义好的 questions(问题)。目前主要有三种判断原语:
Choice(选择):从最多 255 个候选项中选一个,并返回概率分布和置信度;Score(评分):按照 2 到 10 档标准打分,并返回加权分数、分布和置信度;Noul(命题概率):判断一句话成立的概率,返回 0 到 1 之间的数值。
比如收到一条客服消息后,程序可以同时问:这是不是退款请求、应该交给哪个部门、客户情绪有多激烈。Jev 会并行给出三个结构化结果,而不是先写一段分析,再让程序从文字里猜答案。
这就是它和传统大模型最关键的区别:输入仍然可以是模糊的自然语言,但输出空间由程序提前规定。
它带来的新东西,不只是更快
第一层变化是结构可靠。
大模型的能力来自它可以生成任何字符串,不稳定也来自它可以生成任何字符串。Jev 放弃自由生成,只在规定好的答案空间里判断,因此可以在接口层保证输出类型正确。
这里要把边界说清楚:不会返回类型错误,不等于不会判断错误。 它可能选错,只是不会突然给程序塞回一段无法解析的小作文。
第二层变化是把“不确定”正式交给程序。
Jev 把概率和置信度作为原生结果。开发者可以设置阈值:置信度高就自动执行,中间区间转人工,太低则交给更强、也更贵的推理模型。这比让通用大模型自己说“我有 80% 把握”更适合写进稳定的软件流程。
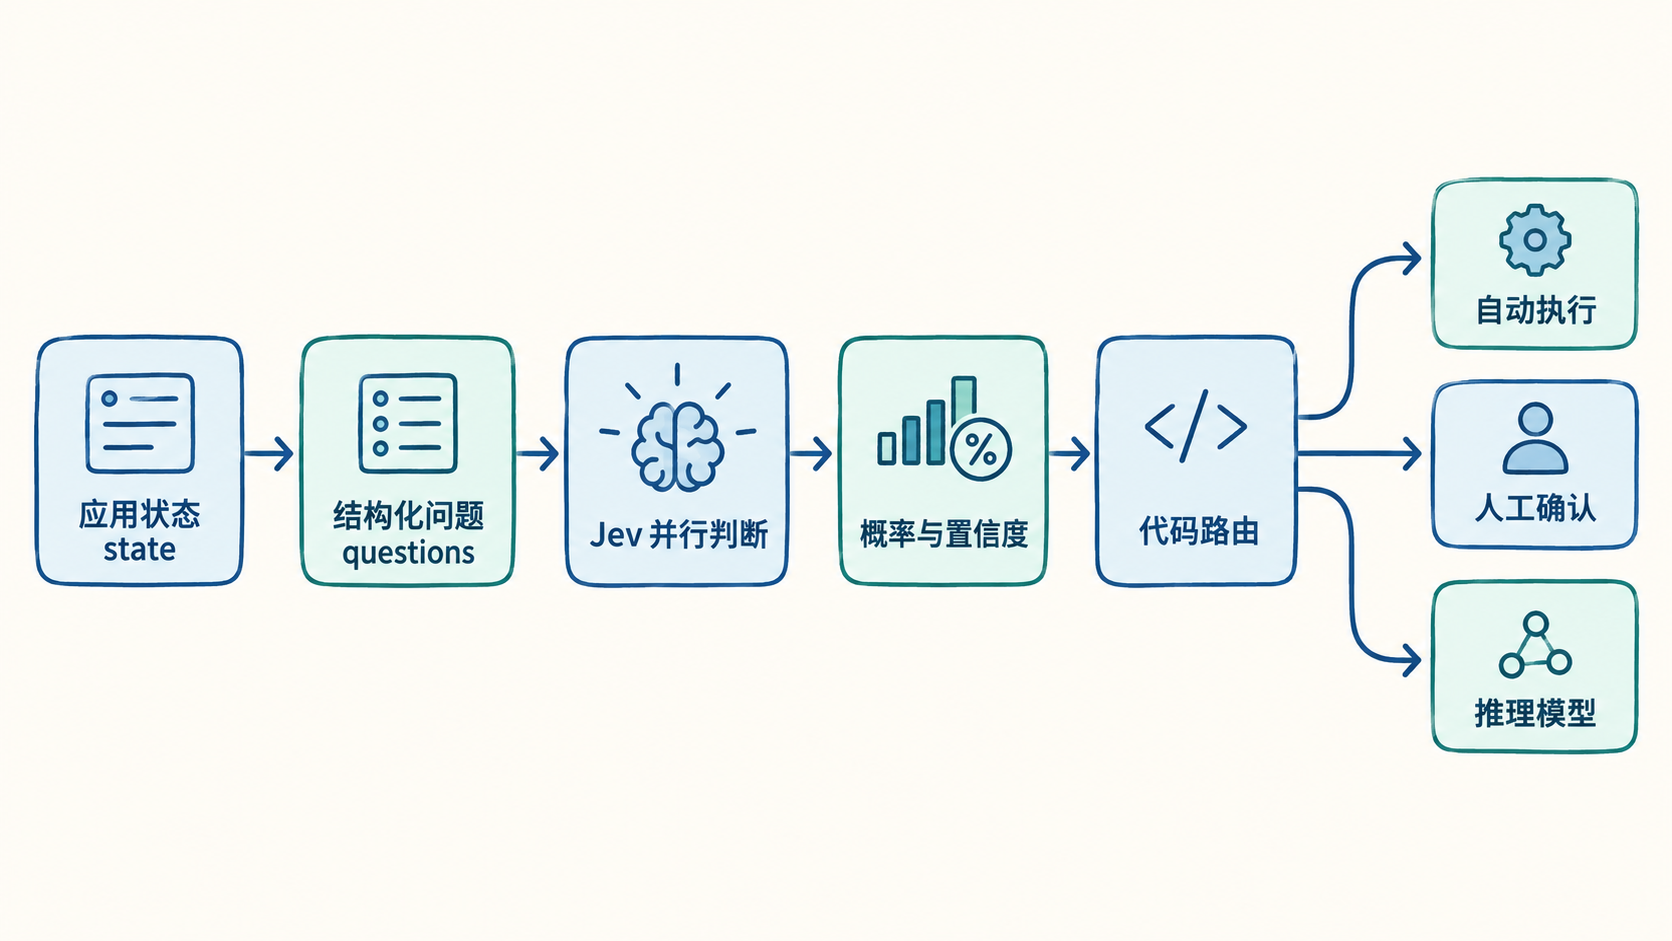
第三层变化是让 AI 决策进入高频逻辑。
Jev 当前价格是每百万输入 token 0.042 美元,输出免费;官方给出的端到端响应时间约为 70 至 500 毫秒。多个问题还能共享同一份状态并行计算,适合“一次输入、多维判断”的任务。
TypeSafe 把模型命名为 Jev,是在致敬经济学家 William Stanley Jevons。背后的隐喻是 Jevons paradox(杰文斯悖论):效率提高未必让资源用得更少,反而可能因为新场景大量出现而增加总需求。
当一次 AI 判断便宜到几乎可以忽略,它就不必等用户专门点一下,而可以进入路由、审核、风控、检索和推荐的每一个小环节。
几个真正把 Jev 特点讲清楚的例子

Agent 的调度员和安全门
这是最现实的用法。Jev 可以判断 Agent 下一步该调用哪个工具,某次工具调用是否越权,或者当前任务应该继续、重试还是转人工。
高置信度的简单任务直接执行,低置信度任务再交给推理模型。Jev 不替代大模型,而是减少它被频繁叫来做小判断的次数。
用 Jev 玩 Doom
TypeSafe 官方做过一个 Doom(毁灭战士)演示。它不是让 Jev 直接看游戏画面,而是把游戏状态整理成带文本的结构化数据,再让模型每秒大约判断 10 次下一步动作。
官方估算,连续运行一小时大约花 7 美元。它当然不是最强的 Doom 机器人,TypeSafe 也承认传统游戏 Bot 可能玩得更好。这个演示主要是在说明:当延迟降到百毫秒级,模型决策可以进入实时交互。
Wikipedia 竞速
另一个官方演示叫 Wikiracing(维基竞速):从一个维基百科词条出发,只能沿当前页面里的链接跳转,最后到达指定页面。
每一步都有大量候选链接,Jev 负责迅速判断哪些更接近目标。它不用编一个听起来合理的新链接,只能在真实候选项里选,这正好体现了有限答案空间的价值。
客服分类和工具调用检查
OpenRouter 的 Jev Lab(Jev 实验页面)还展示了更接近生产环境的结果:95 条客服消息、每条做 5 个判断,共 475 个答案,示例记录约 1.2 秒、0.0014 美元;24 个工具调用、每个做 4 项检查,共 96 个答案,约 0.5 秒、0.0004 美元。
这些只是当次演示,不是永久性能保证,但已经能看出它最适合的任务形状:候选范围明确、调用量大、对延迟敏感。
Jev 不能做什么
Jev 不是 ChatGPT 的替代品。它不会替你写文章、写代码,也不会生成一段解释。目前它只接收文本,图片、音频和视频要先转成文字或结构化字段。
官方文档还明确说明,英语是主要训练语言,效果最好。中文等语言可以处理,但正式接入前要用自己的数据做测试。
概率经过校准,也不代表每一个答案都正确。所谓“90%”应该放在一批相似任务中理解,不能给单次判断盖章。
至于 193.6 倍速度、444.6 倍成本优势,来自 TypeSafe 自己设计的特定工作流评测。公司也提醒,这属于较理想的场景,不代表 Jev 在所有任务上都能全面超过通用大模型。
更准确的结论是:在结构化、短判断、高并发的任务上,Jev 选择了比生成式大模型更合适的产品形态。
现在怎么注册和使用
截至 2026 年 9 月 21 日,TypeSafe 官方控制台已经可以直接注册使用。我们实测新账户进入账单页面后显示 5 美元 Monthly credit(月度赠送额度),本次额度有效期为一个月。金额、有效期和开放政策后续都可能调整,以注册后控制台显示为准。
使用步骤很短:
- 打开 TypeSafe 控制台,注册并登录;
- 进入
Playground(在线试用页),填入一段状态,再添加Choice、Score或Noul问题; - 在 API Keys 页面创建密钥;
- 调用官方接口,或者通过 Vercel、OpenRouter、Cloudflare、LangChain 接入。
最小请求大概长这样:
1 | curl -X POST https://api.typesafe.ai/v1/systemone \ |
官方还提供 Python 和 JavaScript/TypeScript SDK(软件开发工具包)。当前稳定模型是 jev-1.13.0,也可以用 jev-latest 自动指向稳定最新版。
Jev 最值得看的,不是它能不能取代 GPT,而是它重新划了一条边界:需要理解、创作和复杂推理时,用通用大模型;需要在软件里快速做成千上万次小判断时,用专门的决策模型。
AI 的下一步,未必只是让每个程序都更会说话。也可能是让它们在该做判断的时候,真的知道下一步该往哪里走。
参考资料
- TypeSafe AI:Introducing System One Models and Jev
- TypeSafe AI:System One 概念文档
- TypeSafe AI:模型、价格与语言支持
- TypeSafe AI:快速开始
- TypeSafe AI:团队介绍
- Vercel:Jev 接入 AI Gateway
- OpenRouter:Jev Lab
- Cloudflare:Jev 模型文档
- LangChain:TypeSafe 集成文档
- Business Wire:TypeSafe AI 融资与产品发布
资料核对日期:2026 年 9 月 21 日。